SparseLLM
让结构学习走进可部署的语言模型。
- 面向
- 模型开发者与企业 AI 团队
- 合作范围
- 围绕 8B 公开模型、目标任务、服务负载和适配硬件开展联合评估;更大规模模型持续研发。
- 可能交付
- 模型与部署配置,以及包含质量、性能和测量条件的评估报告。
稀疏,孕育真正智能。
以原创 CHT 动态稀疏科学,开创脑启发式稀疏智能,推动下一代人工智能。
以结构学习提升智能密度,让模型与计算系统释放更大的效率潜能。
共同激活的神经元之间,连接可能增强。
公开模型
从脑启发的原创科学,到全球开发者可以探索的公开模型。SparseMind 首个 8B 稀疏语言模型,让结构学习的潜力成为可检验、可复用的起点。
这一里程碑基于 Qwen3-8B 进行结构化稀疏适配,公开模型权重与发布清单,邀请研究者、开发者和硬件伙伴共同推进下一步。
指定权重矩阵的结构化稀疏
公开权重 · 基于 Qwen3-8B 适配
发布清单采用保留 2:4 零值的稠密 BF16 执行路径;系统效率取决于模型、硬件与负载。图形为格式示意。
智能存在于连接的强弱之中。
也存在于连接如何组织。
CHT 让网络探索自己的结构。
让高水平稀疏模型走向多样硬件。
从可探索的模型到稀疏算法与芯片协同设计,为真实工作负载建立可验证的工程路径。
让结构学习走进可部署的语言模型。
让芯片的稀疏能力与模型结构共同进化。
公开成果、工程验证与研发目标,清晰呈现。
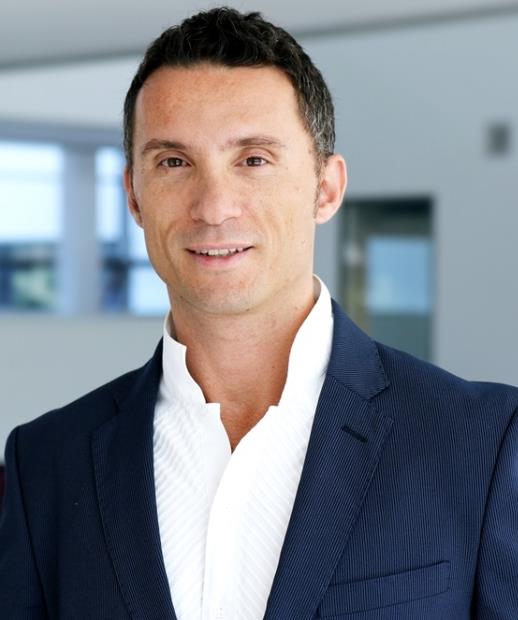 CARLO VITTORIO CANNISTRACI
CHT 源自 Carlo Vittorio Cannistraci 教授及研究团队对脑网络组织与结构学习的原创探索。SparseMind 将科学洞察与模型、硬件和商业团队连接,让研究走向可验证的工程。
学术研究与公司工程进展分开呈现;论文作者与机构归属以原文为准。
认识团队与科学根源从 ICLR 到 NeurIPS,再到 PMLR。
持续推进结构学习与硬件效率。
Cannistraci-Hebb Channel-wise Dynamic Sparse Training of Convolutional Neural Networks with Contextual Modulation,海报论文。
SCHTs: A Semi-Structured Dynamic Sparse Training Framework for Hardware-Efficient Deep Learning,海报论文。
Yingtao Zhang 等 · 探索连接组织和学习能力的关系。
Yingtao Zhang 等 · 通过柔性连接采样和渐进密度变化,扩展动态稀疏训练。
Jialin Zhao 等 · 自适应拓扑规则与复杂网络连接预测。
Jiaqing Lyu 等 · CHTs24 与稀疏重训练,推进硬件友好的 2:4 格式。
查看模型、发布清单与研究路径。
探索公开模型定义模型、硬件与真实工作负载。
讨论计算挑战从原创科学到公开成果与商业方向。
了解 SparseMind